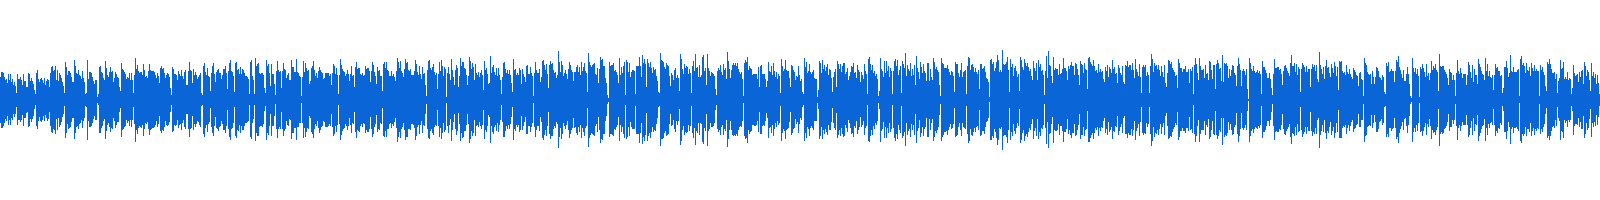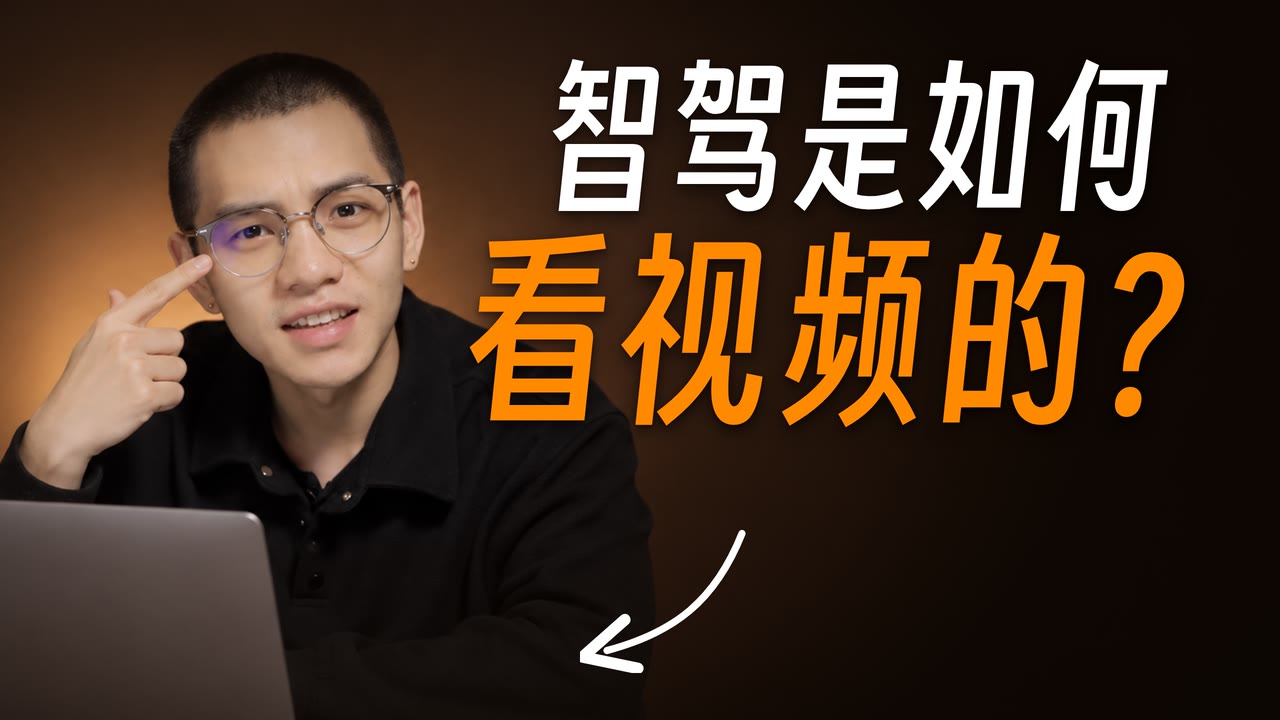
陈与小金 · 视频幕后 · 2026.10.18 – 11.02

10 分钟口播,一个晚上做成全 3D 片子

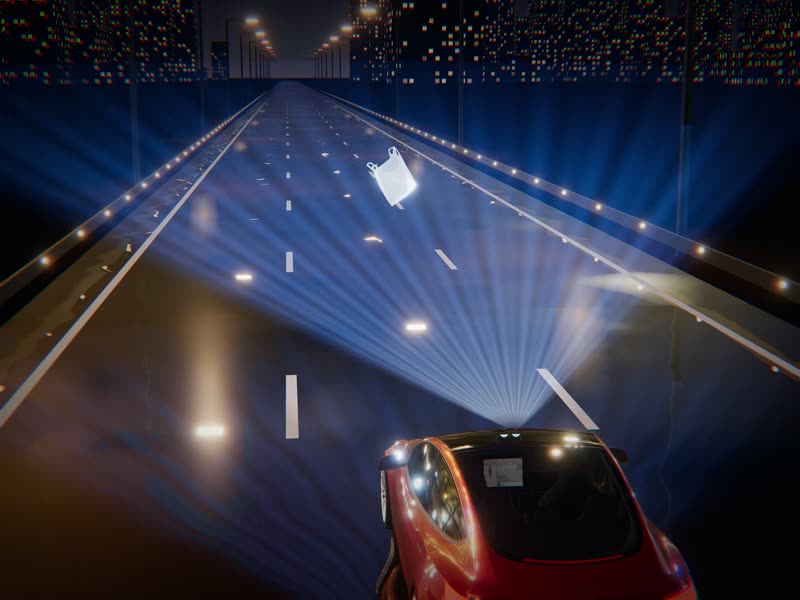
成片《智驾是如何看视频的》,9 分 50 秒,4:3。这期没有我露脸的画面:两次录音摄像头都没进录制软件,只录到了声音。画面全是代码写的 3D——雨后夜路、一辆红车、一个塑料袋。10-27 凌晨 00:56 我给 Claude Code 定下目标,它派了 37 个 agent,06:01 交片,这中间我一条消息没发。

102条我发的消息
4,736次AI 操作(主会话 + 子 agent)
37个包装那一晚派出的 agent
865次那一晚打开自己渲的图检查

    分工

    我拍板、录音、挑毛病,其余 AI 动手

    按做这条片的对话记录数出来。我亲手做的:录两次口播、在达芬奇里剪掉不要的话、调封面位置、点发布。稿子初稿是 Gemini 写的;查资料、剪辑、画面、音效、配乐、字幕、渲染、发布填表,是 Claude Code 和它派出去的 agent 做的。

    时间线

    10-18 立项,10-28 首发

    按对话记录和工作日志排出来。前九天在磨稿子和录音,画面是 10-27 一个晚上做出来的。
    10-18

    立项、事实卡、初稿

    成片画面:那开车的 AI 呢?
    • 上期评论区又有人问「1 秒 1 帧的话,智能驾驶怎么办」,我说继续做
    • 两个子 agent 同时查事实卡:帧率与训练、塑料袋与长尾
    • Gemini 4 Argon 写出 v1;查了 YouTube,没有专讲这个的
    10-20 – 10-22

    按最新技术重写,到 v9

    成片画面:虚拟世界
    • 我说「用最新的技术去讲」:三个子 agent 查 2026 年新进展,主会话逐条抓原文核,出第三张事实卡
    • 核对挑出 v4 的 7 处事实偏差;砍字 3,850 → 3,100
    • 「念出来检查」:45 句,每句给 3 种说法让我挑
    10-22 – 10-23

    首录、续写 v10

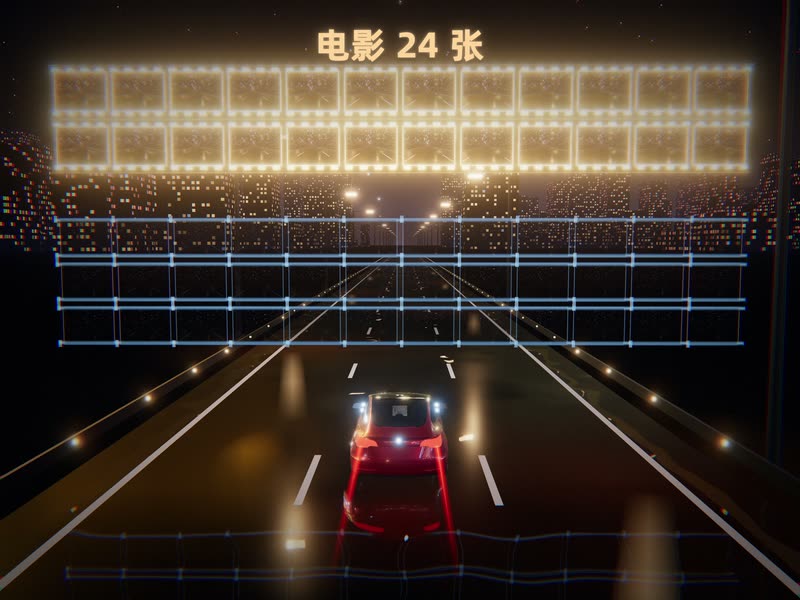
    成片画面:电影 24 张和车 36 张
    • 10-22 夜里录了前三分之一(7:16),只有声音;AI 粗剪 21 刀、染色
    • Gemini 照我录音的口气续写后三分之二
    • 我问「0.9 米很短吗」,自己想到电影 1 秒 24 帧:车看 36 张,比电影还多 12 张
    10-24 – 10-26

    重录、粗剪、补气口

    定剪后的口播干声波形,9 分 49.6 秒
    • 全篇重录 19:17,又只有声音
    • AI 粗剪、预切 151 段;我删掉不要的话;AI 逐个判断 138 处停顿
    • 定剪 9:49.6;导出时修了 39,704 个被削平的采样
    10-27 00:56 – 06:01

    一晚包装

    成片画面:20 亿 token 的星系
    • 定下目标后我没再发消息
    • 12 个 agent 并行各搭一段 3D;另有 agent 做音效、配乐、备选开头、精修
    • 交付前自查修了定格、空音效、一百多帧闪烁
    10-27 下午

    看片返修

    换成 Model 3 车模后的画面
    • 我提:车不像特斯拉、地面光效乱、字幕字体不对、Waymo 读错
    • AI 换车模、改倒影、换字幕、克隆音补 1.7 秒,12 段重渲
    • 开头运镜改了两次都不如原版,退回
    10-27 晚 – 11-02

    物料、封面、发布

    封面:智驾是如何看视频的?
    • 定标题「智驾是如何看视频的」,和上期《模型是如何看视频的》成对
    • AI 填表、查历史数据定在傍晚:10-28 17:30 首发
    • 11-02 其余五个平台,AI 传片填表,发布键我点
    一共

    13 段对话 · 43 个子 agent

    • 我 102 条消息,10-27 一天就有 39 条:凌晨定剪,下午看片返修,晚上发布
    • 10-27 一天 AI 操作 3,840 次,占全部的八成
    • 11-02 发布那晚 286 次,大多是在浏览器里填表
    稿子

    10 版稿子,录的时候又改了 28 处

    稿子靠事实卡兜底:三张事实卡由子 agent 查,主会话逐条打开原文核。最后成片说的话和 v10 还有 28 处不同,录音时我又换了一些说法,成片字幕按我实际说的写。

    Gemini 4 ArgonClaude Code外部编辑
    v110-18 · Gemini

    按两张事实卡写初稿,8 段约 7.5 分钟

    v210-18 · Claude Code

    按我的意见加回「树枝 vs 转向灯」,27 句改说法

    v310-20 · 外部编辑

    删到约 2,000 字,开头直接讲塑料袋追尾

    v410-21 · Gemini

    我要「用最新的技术去讲」,按第三张事实卡重写

    v510-21 · Gemini

    修核对挑出的 7 处事实偏差

    v610-21 · Claude Code

    只删原句,约 3,850 → 3,100 字

    v710-21 · Claude Code

    拔掉「第一站…第六站」这种报站腔

    v810-21 · Claude Code

    合入我在 v6 里勾的 11 句

    v910-22 · Gemini

    只修 4 处小问题,开头逐字保留

    v1010-23 · Gemini

    前三分之一照我实际录的整理,后三分之二照我的口气续写

    剪辑

    19 分 17 秒 → 9 分 50 秒

    全篇重录只有声音。剪辑在达芬奇里:AI 通过脚本粗剪、染色、补气口,我在它染好色的时间线上删不要的话、听停顿。

    每一步之后还剩多长

    留下的AI 染粉:建议删染橙:要我听
    定剪后的口播干声波形

    定剪后的口播干声,9:49.6,17,688 帧,155 段。原录音约 0.8 秒超过 0 dB,达芬奇导出会把这些采样削平;AI 按剪点从原始录音重拼,只替换了 39,704 个被削平的采样,其余和达芬奇导出逐采样一致。

    卡壳3 帧
    句中换气5 帧
    句末8 帧
    换段落15 帧
    抛问题18 帧

    补气口:我问「标准的气口停顿是多少帧」,AI 先给全片统一 8 帧,我说要按「一句说完了」还是「卡壳停顿」分开判断。它把 138 处停顿逐个读前后文字归成上面五类再压或补;第一版留下很多 1–2 帧的碎片,我发现后它重剪了一版。我还说:别发判定表给我看,直接剪完,要我听的地方染色。

    一晚包装

    00:56 定目标,06:01 交片

    10-27 凌晨,我在一段新对话里给 Claude Code 定下目标,开了 max 档和工作流模式。到下午 13:58 我回来看片之前,这段对话里我没有再发一条消息。下面是它这一晚每条线在忙什么,按对话记录里的时间画出来。

    0条这一晚我发的消息
    37个派出去的 agent
    3,216次操作(主会话 616 + agent 2,600)
    58分钟12 段并行搭完

    这一晚的时间图

    主会话agent渲染合成自查返修

    时间取自对话和每个 agent 记录的首末时间,精确到分钟;悬停或聚焦色块看说明。12 段每段一个 agent,各在一份独立的工程副本里干活,交付后主会话再合回主工程。

    00:56 – 01:3277 句 · 17,688 帧

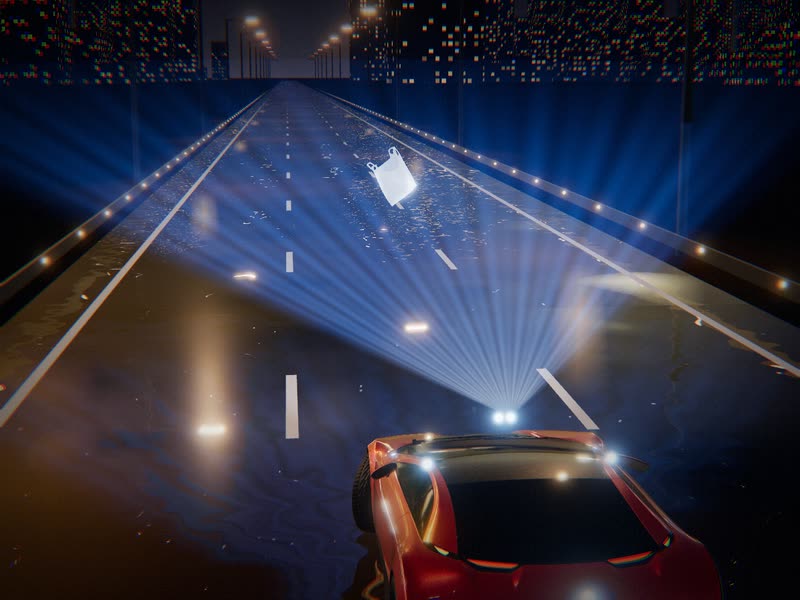
    主会话先读稿和时间表,搭工程(4:3、30 帧),再建所有段共用的 3D 世界:雨后夜路、红车、塑料袋、远处城市。第一次试渲一片白雾,它查出是镜头站进了车灯光锥。

    01:44紫 5.3% → 1.7%

    12 段在搭的时候,它给共用的画面加了全局调色:路面黄绿色 3.4% → 0.6%,偏紫的像素压到 1.7%,再推给 12 份副本,让每段都在最终的色调上调。

    02:15拆出配乐

    做音效素材包的 agent 到 02:15 还没开始配乐,主会话把活拆开:它只管素材包(最后 132 个声音、37 类),另派一个专门配乐(Lyria 生成,D 小调 120 BPM,按画面重拍对位)。

    02:30 – 02:4613 个 agent · 几分钟

    按每段画面写音效点位,每段一个 agent,两三分钟写完。素材包里缺的声音(快门、转向灯、脚步、气刹……)它们会标出来,主会话再让做素材包的补。

    02:38 – 03:09精修 7 段

    主会话逐段看完,挑出最弱的镜头列成单子,派 7 个 agent 定点精修:只改造型、机位、质感,不改动作时间。

    03:29 – 03:33568 个音效

    12 段渲完,帧数加起来正好 17,688。混音:配乐比人声低约 12 dB,压在字上的音效自动让开,整片 -15.0 LUFS。字幕 315 条。

    12 段画面

    一段一个 agent,同时开工

    按口播切成 12 段,切点都落在两句之间的停顿里。下面是成片里每段的一小截,以及搭这段的 agent 用了多久、操作几次、打开自己渲的图检查几次。蓝标的 7 段后来又精修过。全部是 three.js 代码写的 3D,在 Remotion 里逐帧渲,2880×2160 原生出图,没有用视频生成模型。
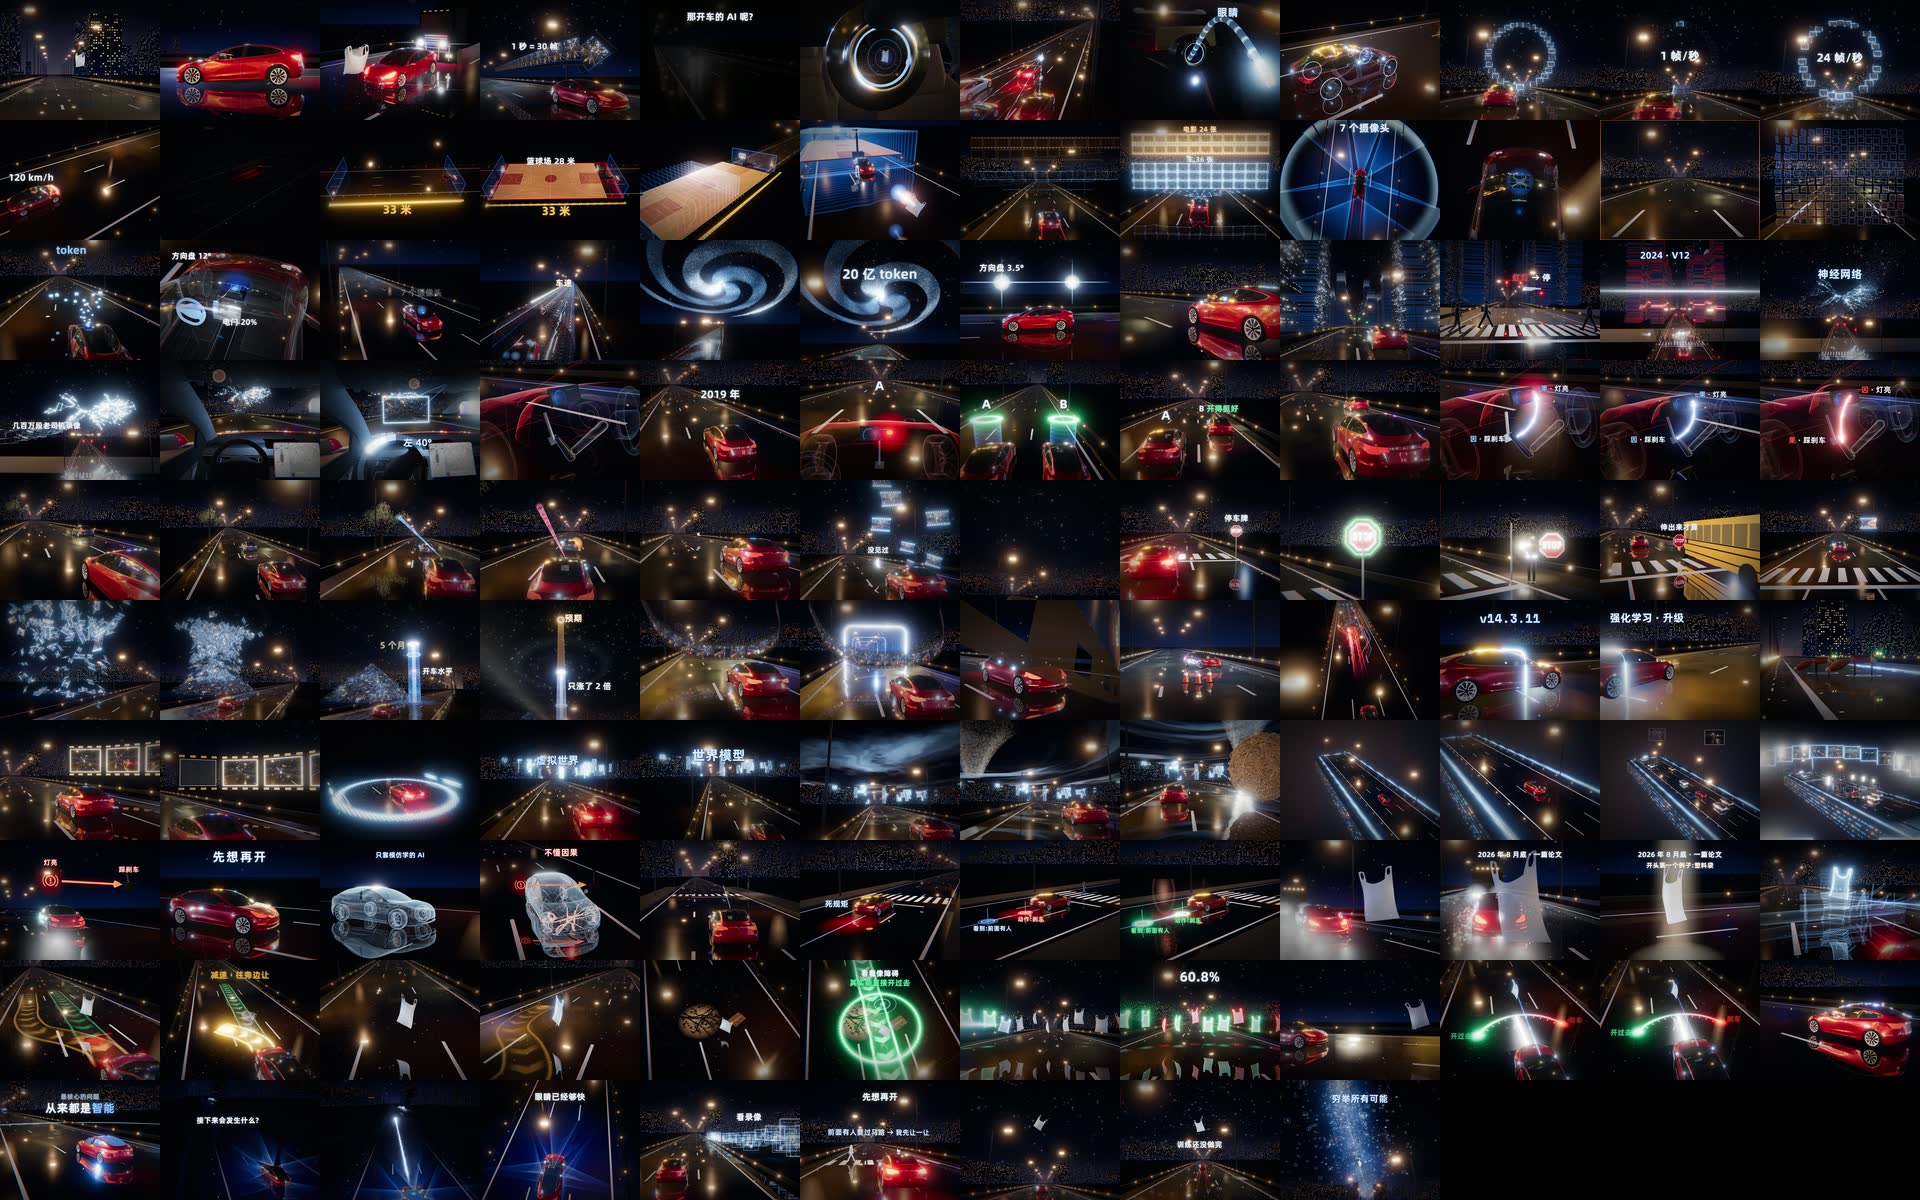
    成片每 5 秒一帧拼成的总览图
    整条片每 5 秒一帧 从左到右、从上到下。同一条夜路、同一辆车、同一个塑料袋贯穿全片。
    自查

    交片前,它自己找出来的错

    03:38 第一次写好交付说明后,它没有停,接着抽帧、量声音、查时间戳,又找出两个大错。下面都是这一晚它自己发现、自己修的。
    时间发现怎么处理的
    01:48镜头站在车前时,画面一片白雾查出是镜头站进了车灯的光锥,光锥改成默认关、亮度限幅。
    02:36有几下音效比人声还响,最多高 17 dB音效轨加「护字」:压在字上的那一下自动让开。
    03:31替换占位音效的 agent 半小时没动静停掉它,主会话在 130 个占位点里按规则换掉能明确对上的;误换的 4 处从版本记录原样恢复。
    03:42第 5589 帧镜头跳了一下逐帧定位到这一帧,先补帧,后来随路面问题一起修掉,复查不再出现。
    04:03第 5 段整整 39 秒定格单独补过一帧的那块和其他段格式对不上,拼起来卡住了。重拼。
    04:09交付的成片里没有音效一个后台 agent 做了次「不带音效」的试混,把正式混音覆盖了。重混,568 个音效全回来。
    04:09让千问看片、听声,它指出二十多处画面问题、几处刹车声刺耳只当线索,逐帧核对:一半左右是千问看错,剩下的是故意的效果,没改。刹车声量了比人声低 5–6 dB,留给我自己听。
    04:54镜头升高时路面一闪一闪:6 段、一百多帧第一版当成故意的闪烁放过了。查出是画面引擎的深度精度不够,修好后 6 段重渲,逐帧和旧版对比,只有原来闪的帧变了。
    06:328 个「等渲染完」的脚本一直不结束它们的判断条件把自己也算进去了,永远等不完。真正的合成 05:53 已结束,全部停掉。
    调色前后对比:左边路面偏黄绿,右边偏暖
    01:44 全局调色 工程里当晚留下的检查图。左:调色前,路面偏黄绿;右:调色后。这时用的还是第一版车模。
    看片返修

    我看片说的,AI 怎么改的

    10-27 下午我看完第一版。画面我觉得「很可以」,提了四处,都改了;开头运镜那一处,改了两次都不如原版,退回。
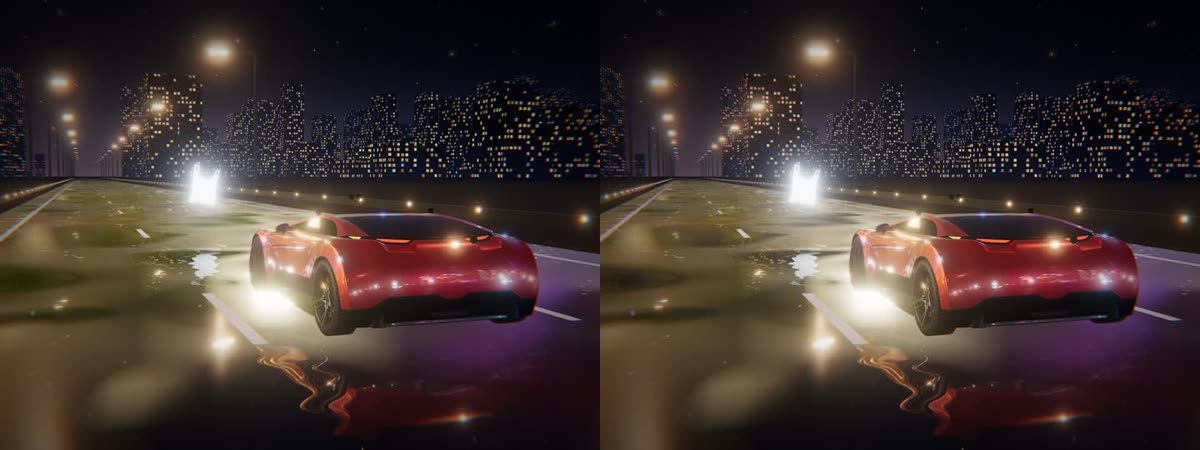
    第一版:概念车模
    第一版 第 8 秒:用的是 Khronos 开源的概念车模。
    返修后:Model 3 车模
    返修后 同一帧:换成 Model 3 车模,湿路倒影不再映城市窗户和星星。
    10-27 13:58智驾的视频,我觉得画面是很可以,但是车不像一个特斯拉换成 Ameer Studio 的 Model 3 车模(CC BY 4.0,简介里署名),车标、车牌藏掉;车内镜头和 7 个摄像头按左舵重新对位。
    10-27 13:58同时地面的光效有点太多了,导致画面看起来很杂乱碎亮点是湿路倒影映了远处城市的窗户和星星。去掉,只留车和路灯的倒影,水纹调柔。
    10-27 13:58然后字幕是我之前的字体吗?我觉得不太对诶。换回之前在达芬奇里用的那套:普惠体粗体白字 + 半透明黑底框。
    10-27 15:03不对啊,这个克隆音完全不像,你只能用我当前视频的声音去克隆,不能用之前的Waymo 这个词我没读对。只用这条片的干声克隆,出了几版,我挑 B,补进 6:26.1–6:27.8 这 1.7 秒,其余采样不动。
    10-27 16:58开头是很好的很强的,我只是觉得镜头的移动有点快,我有点晕拆成 5 个镜头、把最快的速度砍一半,都试过。我说:「这不行,还不如之前的……你回到那一版吧。」最后:「就用已经导出的吧,发布一下。」
    发布

    标题和上期成对,傍晚首发

    封面:智驾是如何看视频的?
    封面 无字底图换过一次动作,我挑了「手指点眼角」那张,字的位置是我在编辑器里自己调的。
    • 标题:我定「智驾是如何看视频的」,和上期《模型是如何看视频的》成对。
    • 首发:AI 打开上传页、填标题简介和话题、勾 AI 生成声明、传封面;2.2 GB 的成片是我拖进去的(浏览器工具一次只能传 10 MB)。
    • 几点发:我问当晚发还是早上下午发。AI 查了平台数据快照里 66 条作品:傍晚 17–20 点那 20 条,播放和收藏的中位数都是各时段最高。定时 10-28 17:30。
    • 其余五个平台:11-02 傍晚,AI 传片、填表、传封面和字幕,发布键我点。
    我说过的话

    改变了片子的那几句

    102 条消息里,很多是「打开我看看」「做吧」。真正改了片子的是下面这些。

    10-18智能驾驶的那个稿子,评论区又有人问,1秒1帧的话,智能驾驶怎么办?我觉得可以继续弄。立项。
    10-21用最新的技术去讲,最新的。应该是什么样子三个子 agent 查 2026 年新进展,重写 v4。
    10-21核对原文啊、主会话逐条打开原文核,出第三张事实卡。
    10-23我觉得这个 0.9 米不就 90 厘米吗?90 厘米在实际开车的过程中,它不是也很慢吗?我觉得是很慢的。删掉 0.9 米。我自己想到电影 1 秒 24 帧,换成「车看 36 张,比电影还多 12 张」。
    10-23在看看剩下的,所有的概念必须简单易懂。后三分之二改了 8 处说法,比如「世界引擎」改成「服务器上的虚拟世界」。
    10-26我还没有剪气口呢,我只是去掉了不要的话。然后我想挖深一点,标准的气口停顿是多少帧?按停顿类型定帧数,138 处逐个判。
    10-27要在另外的一个对话里面去完全自主地做这个视频剪辑那段对话里做的包装半成品删掉,另开一段对话从头自主做。
    10-27不对啊,这个克隆音完全不像,你只能用我当前视频的声音去克隆,不能用之前的只用本片干声克隆,我挑 B。
    10-27这不行,还不如之前的最开始取消镜头晃动之前的那一版,你回到那一版吧。开头运镜退回原版。
    收获

    做完这条,我记住了三件事

    1

    给目标,让它跑一夜

    定好目标、开 max 档,它自己拆成 12 段、派 37 个 agent,做配乐的卡住了它会拆活,替换音效的 agent 不动了它会停掉自己做。我一条消息没发,早上就有成片。

    2

    它会自己找错,但看片还得我

    39 秒定格、空音效轨、一百多帧路面闪烁,都是它交付前自己查出来的。车不像特斯拉、镜头看着晕、Waymo 读错,是我看片看出来的。

    3

    改不好就退回

    开头运镜我嫌快,拆镜头、改速度曲线都试了,都不如原版。直接用已经导出的那版发。

    问答

    常见问题

    画面是视频生成模型做的吗?

    不是。全部是 three.js 代码写的 3D,在 Remotion 里逐帧渲出来,2880×2160 原生出图。车模是 Ameer Studio 的「Tesla 2018 Model 3」(CC BY 4.0),路人车是 Khronos 的「Car Concept」(CC-BY 4.0),环境光是 Poly Haven 的 CC0 HDRI。

    这条片用的什么模型?

    Claude Code 主力是 Opus 5.5,包装那晚开的 max 档;立项、首录粗剪、重录粗剪三段对话用的是 Fable 5.1。稿子初稿和 4 轮改稿是 Gemini 4 Argon 写的,配乐是 Lyria,Waymo 那 1.7 秒是 Fish 克隆音,AI 还让千问看片、听声当线索。

    人做了什么,AI 做了什么?

    我拍板选题、录两次口播、在达芬奇里删掉不要的话、听气口、看片挑毛病、挑封面底图并调位置、点发布,一共 102 条消息。其余是 AI:Claude Code 主会话 1,885 次操作,43 个子 agent 2,851 次操作。

    为什么这期没露脸?

    两次录口播,摄像头都没进录制软件,只录到了声音。

    12 段是怎么拼成一条的?

    主会话先搭好所有段共用的 3D 世界(路、车、袋子、灯光、调色),再按口播在两句之间的停顿处切成 12 段,每段复制一份独立工程交给一个 agent。各段首尾帧都落在同一个世界里,接缝是硬切;主会话合回后逐个检查了接缝的首尾帧。

    花了多少钱?

    没算出来。这期没有用 claude -p,工作流的记录里只有 token 数、没有金额:包装那晚 6 次工作流(32 个 agent)合计约 811 万 token。主会话和其余 agent 的用量没有统计。